ラベル MCMC の投稿を表示しています。 すべての投稿を表示

2009年3月16日月曜日

BRugsによる正規母集団パラメータのベイズ推定

 RからライブラリBRugsを介してOpenBUGSを使用するベイズ推定の一例を示す。
Xi(i=1~n)を正規分布(平均μ、分散σ2)に従う母集団からのi.i.d.サンプルとする。μ、σ、σ2等のベイズ推定を行う。なお、事前分布やハイパーパラメータの値には以下と同じものを用いる。
・R2WinBUGSによる正規母集団パラメータのベイズ推定
(参考文献)豊田秀樹編著「マルコフ連鎖モンテカルロ法」、朝倉書店、2008年。

1.パッケージBRugsのインストール
Rを起動して「パッケージ」-「パッケージのインストール」をクリックするとCRANのミラーサイトを選択する画面が表示される。適当なサイトを選択して「OK」を押すと、パッケージを選択する画面が表示される。

「BRugs」を選択して「OK」を押すとダウンロードが始まる。パッケージは約5.5MBのzipファイルで、一時ファイルフォルダにダウンロードされる。

ダウンロードされたパッケージをRに読み込むため、「パッケージ」-「パッケージの読み込み」をクリックする。

パッケージから「BRugs」を選択し「OK」を押すと読み込みが始まる。読み込み終了後、RのフォルダlibraryにフォルダBRugsがあることを確認すればインストールは完了する。

2.モデルファイル(model.txt)、データファイル(data.txt)及び初期値ファイル(inits.txt)
BUGSではモデルファイル、データファイル及び初期値ファイルを用いて事後分布からサンプリングを行う。事前分布や尤度関数等の情報はモデルファイルに、所与のデータ情報はデータファイルに、計算に用いる初期値の情報は初期値ファイルに収められている。使用する各ファイルを適当なエディタを用いて以下のように作成し、ワーキングディレクトリに保存する。
1)model.txt
model{
mu ~ dnorm(0, 100) # 事前分布
tau ~ dgamma(18, 0.68) # 事前分布
sig2 <- 1/tau
sig <- sqrt(1/tau)
for(i in 1:n) {
X[i] ~ dnorm(mu, tau) # 尤度関数(サンプルX[i]の母集団分布)
}
}
2)data.txt
list(n=6, X=c(4.59000E-02, 4.36000E-02, 2.07000E-02, 8.67000E-02, 1.67800E-01, 1.74800E-01))
3)inits.txt
list(mu=0, tau=1)
なお、初期値ファイルは連鎖の数だけ必要である。特に初期値の設定に条件がない場合は、連鎖の数に自動対応する初期値の生成関数modelGenInits()を用いると便利である。

3.BRugsの関数を用いたRコードの一例
以下のコードを適当なファイル名を付けてワーキングディレクトリに保存し、Rから実行する。
library(BRugs)
Ne <- 10000 # 有効サンプル数
Nb <- 1000 # burn-in
N <- Nb+Ne # 総繰返し数
modelCheck("model.txt")
modelData("data.txt")
modelCompile(numChains=1)
modelInits("inits.txt") # 初期値を自動生成する場合はmodelGenInits()を使用する。
samplesSet(c("mu","tau","sig","sig2")) # パラメータの指定。
modelUpdate(N)
samplesStats("*") # すべての変数の統計量を表示する。
samplesHistory("mu", beg=Nb)
samplesDensity("mu", beg=Nb)
samplesCoda("mu",stem="mu") # パラメータmuのCodaファイルをワーキングディレクトリに生成する。
CD <- read.openbugs(stem="mu") # パラメータmuのMCMCオブジェクトをCDとする。
codamenu()

4.結果の表示(「・・・・・」は一部割愛を表す。)
> modelCheck("model.txt")
model is syntactically correct
> modelData("data.txt")
data loaded
> modelCompile(numChains=1)
model compiled
> modelInits("inits1.txt")
Initializing chain 1: model is initialized
> samplesSet(c("mu","tau","sig","sig2"))
monitor set for variable 'mu'
monitor set for variable 'tau'
monitor set for variable 'sig'
monitor set for variable 'sig2'
> modelUpdate(N)
11000 updates took 0 s
> samplesStats("*")
mean sd MC_error val2.5pc median val97.5pc start sample
mu 0.05698 0.060660 5.836e-04 -0.06118 0.05783 0.17610 1 11000
sig 0.18650 0.020810 1.995e-04 0.15090 0.18470 0.23230 1 11000
sig2 0.03522 0.008037 7.804e-05 0.02277 0.03412 0.05396 1 11000
tau 29.80000 6.500000 5.965e-02 18.54000 29.31000 43.92000 1 11000
> samplesHistory("mu", beg=Nb)
 >samplesDensity("mu", beg=Nb)
>samplesCoda("mu",stem="mu")
CODA files written
>CD <- read.openbugs(stem="mu")
・・・・・
> codamenu()
CODA startup menu
1: Read BUGS output files
2: Use an mcmc object
3: Quit
Enter an item from the menu, or 0 to exit
選択: 2
Enter name of saved object (or type "exit" to quit)
1:CD
Checking effective sample size ...OK
CODA Main Menu
1: Output Analysis
2: Diagnostics
3: List/Change Options
4: Quit
選択: 1
CODA Output Analysis menu
1: Plots
2: Statistics
3: List/Change Options
4: Return to Main Menu
選択: 4
CODA Main Menu
1: Output Analysis
2: Diagnostics
3: List/Change Options
4: Quit
選択: 4
Are you sure you want to quit (y/N)?
:y

2009年2月9日月曜日

R2WinBUGSによる正規母集団パラメータのベイズ推定

BUGS(Bayesian Inference Using Gibbs Sampling)は以下のような方法で利用できる。
1)OpenBUGS やWinBUGS14をインストールし、単体で使用する。
2)RからライブラリR2WinBUGSを介してOpenBUGSやWinBUGS14を使用する。
3)RからライブラリBRugsを介してOpenBUGSを使用する。
ここでは2)の方法による一例を示す。
Xi(i=1~n)を正規分布(平均μ、分散σ2)に従う母集団からのi.i.d.サンプルとする。μ、σ、σ2等のベイズ推定を行う。
・参考文献
[1]大森裕浩「MCMCの基礎と統計科学への応用」、
http://www.e.u-tokyo.ac.jp/~omori/MCMC/mcmc-ism04.pdf、2004。
[2]中妻照雄「入門ベイズ統計学」、朝倉書店、p.145。

1.事前分布


以下では、ハイパーパラメータの値をμ0=0、τ02=0.01、ν0=36、λ0=1.36(文献[2])と設定したときの例を示す。

2.modelファイル
次のmodelコードをファイルmodel.txtとして作業ディレクトリに保存する。
model{
mu ~ dnorm(0, 100) # 事前分布。BUGSではdnorm(mean, tau)=N(mean, σ2)、
# ここに、 tau = 1/σ2 であることに注意。
tau ~ dgamma(18, 0.68) # 事前分布
var <- 1/tau # var ~ 逆gamma分布
sig <- sqrt(1/tau)
for(i in 1:n) {
X[i] ~ dnorm(mu, tau) # 尤度関数
}
}

3.Rコードの一例
# bugs関数ではmodel.file="model.txt"として2.で作成したファイルmodel.txtを指定する。
# データは参考文献[2]を使用。
# 結果の表示のためcodamenu()(ライブラリはcoda)を用いる。
# このRコードは適当なファイル名を付けて2.と同じ作業ディレクトリに保存する。
library(R2WinBUGS)
library(coda)
X <- c(4.590E-02, 4.360E-02, 2.070E-02, 8.670E-02, 1.678E-01, 1.748E-01)
n <- NROW(X)
data <- list("n","X")
ini1 <- list(mu=10, tau=0.4) # 初期値
param <- c("mu","tau","sig","var")
N <- 10000 # サンプル数
Nb <- 1000 # burn-in
out <- bugs(data,inits=ini1,param,model.file="model.txt", debug=T,
n.chains=2, n.thin=1, n.iter=N, n.burnin=Nb,
bugs.directory="C:/Program Files/WinBUGS14/", working.directory=NULL)
print(out,digits=4)
codamenu()

4.結果の表示(「・・・・・」は一部割愛を表す。)
> print(out,digits=4)
Inference for Bugs model at "model.txt", fit using WinBUGS,
2 chains, each with 10000 iterations (first 1000 discarded)
n.sims = 18000 iterations saved
mean sd 2.5%
mu 0.0567 0.0602 -0.0622
tau 29.7734 6.6214 18.2000
sig 0.1867 0.0213 0.1505
var 0.0353 0.0082 0.0227 ・・・・・
97.5% Rhat n.eff
mu 0.1760 1.0010 18000
tau 44.1400 1.0010 18000
sig 0.2344 1.0010 18000
var 0.0549 1.0010 18000
For each parameter, n.eff is a crude measure of effective sample size,
and Rhat is the potential scale reduction factor (at convergence, Rhat=1).
・・・・・
> codamenu()
CODA startup menu
1: Read BUGS output files
2: Use an mcmc object
3: Quit
選択: 1
Enter CODA index file name 注) WinBUGS14はCODAファイルを自動生成する。
(or a blank line to exit)
1: codaIndex.txt
Enter CODA output file names, separated by return key
(leave a blank line when you have finished)
1: coda1.txt
2: coda2.txt
3:
Abstracting deviance ... 9000 valid values
Abstracting mu ... 9000 valid values
・・・・・
Checking effective sample size ...OK
CODA Main Menu
1: Output Analysis
2: Diagnostics
3: List/Change Options
4: Quit
選択: 1
CODA Output Analysis menu
1: Plots
2: Statistics
3: List/Change Options
4: Return to Main Menu
選択: 1


Save plots as a postscript file (y/N) ?
N
CODA Output Analysis menu
1: Plots
2: Statistics
3: List/Change Options
4: Return to Main Menu
選択: 4
CODA Main Menu
1: Output Analysis
2: Diagnostics
3: List/Change Options
4: Quit
選択: 4
Are you sure you want to quit (y/N)?
:y

2009年2月1日日曜日

Metropolis-Hastings(MH)乱数の自己相関

  MHアルゴリズムによるN(0,1)からのサンプリングを行う。提案分布は一様分布とする。乱数の自己相関の状況について、特に採択率やthinningを変えた場合の影響を例示する。

1.Rコードの一例
thin <- 0 #サンプリング間隔(0のとき間引きなし)
thin1 <- thin+1
Ne <- 1000 # 有効サンプル数
N <- thin1*Ne # 総サンプル数
samp <- numeric(Ne)
count <- 0 # 採択数のカウント
x0 <- 4.5 # 初期値
a <- 4 # 採択率の調整
samp[1] <- x0
for (i in 1:N) {
cand <- runif(1, -a, a) # 提案分布(一様分布)から乱数生成
x1 <- x0 + cand # random walk
alpha <- min(1, dnorm(x1)/dnorm(x0)) # 採択確率の計算、提案分布は対称
u <- runif(1)
if (u < alpha){
x0 <- x1
count <- count + 1
}
if(i %% thin1 == 0){
j <- (i+thin1)/thin1
samp[j] <- x0
}
}
count/N #採択率
mean(samp)
sd(samp)
par(mfrow=c(2,1))
plot(samp,type="l")
hist(samp) # 密度関数を描くときは plot(density(samp))
par(mfrow=c(1,1))
par(ask=TRUE)
NN <- N/2
for(i in 1:NN){
j <- 2*i-1
plot(samp[j],samp[j+1],xlim=c(-5,5),ylim=c(-5,5),col="blue")
par(new=T)
}
par(new=F)
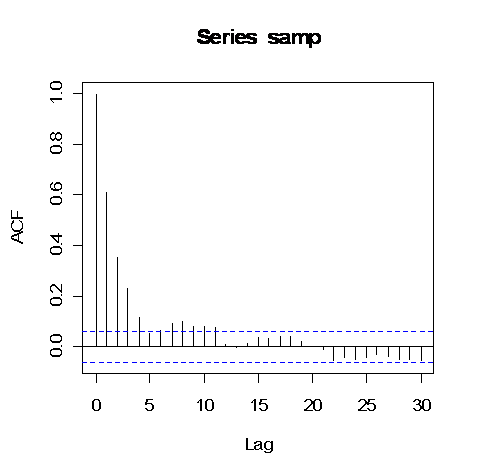
acf(samp) # 自己相関係数
# http://aoki2.si.gunma-u.ac.jp/R/acf.html には自己相関係数を計算する
# 関数acf2(x,k)のRコードが掲載されている。

2.採択率と調整パラメータの関係など(有効サンプル数=10000)
a
thin
採択率
サンプル平均 サンプル標準偏差
4 0 0.399 0.0192 0.9855
4
3
0.388
-0.0119 1.0055
4 6 0.389 -0.0037 1.0025
1
0
0.800
0.0806 0.9881
1 3 0.805 -0.0092 1.0058
1
6
0.802
0.0059 0.9966

3.結果の表示(有効サンプル数=1000)
・thin=0(a=4)

・thin=3(a=4)


・thin=10(a=4)

・thin=0(a=1)


・thin=3(a=1)

・thin=10(a=1)

採択率が0.3~0.4であれば、thin=3でも自己相関の低下にはかなり効果的と思われる。

2009年1月31日土曜日

Metropolis-Hastings(MH)アルゴリズムを用いた正規母集団パラメータのベイズ推定

Xi (i = 1~n)を正規母集団N(μ、σ2)からのi.i.d.サンプルとする。MHアルゴリズムによるμとσ2のベイズ推定例を示す。
(参考文献)大森裕浩「マルコフ連鎖モンテカルロ法の基礎と統計科学への応用」、計算統計II(第III部)、岩波書店、p.168。

1.事前分布


2.尤度関数


3.事後分布


4.未知パラメータの全条件付事後分布


5.MHアルゴリズム
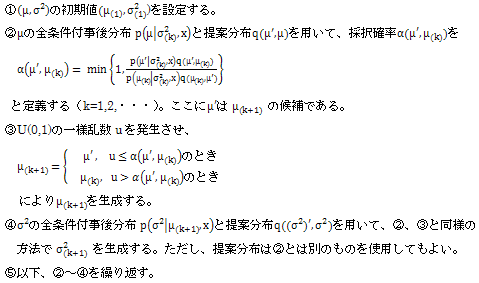
各パラメータの全条件付事後分布に基づくアルゴリズムを採用する。提案分布が対称(q(a,b)=q(b,a))のとき、MHアルゴリズムはMetropolisアルゴリズムと呼ばれる。また、提案分布が全条件付事後分布に等しい場合は、下の採択確率が1となり、p(μ'|σ(k)2,x)及びp((σ2)'|μ(k+1),x)から順次サンプリングを行うことになるので、MHアルゴリズムはGibbsサンプラーに一致する。


6.Rコードの一例
#μとσ2ともに正規分布を提案分布として用いた場合の例。
library(MCMCpack)
X <- rnorm(100,5,1)
n <- NROW(X)
Xbar <- mean(X)
Sum2 <- sum((X-Xbar)^2)
mu0 <- 0.0 # ハイパーパラメータ
sig20 <- 1000 # ハイパーパラメータ
nu0 <- 0.0005 # ハイパーパラメータ
ramda0 <- 0.0005 # ハイパーパラメータ
N <- 100000 # サンプル数
Nb <- 1000 # burn-in
sample_mu <- 1:N
sample_sd <- 1:N
sample_var <- 1:N
sig2 <- 1.0 # 初期値
sig <- 1.0 # 初期値
mu <- 0 # 初期値
var <- 1 # 初期値
N_mu <- 0 # 採択率計算用
N_var <- 0 # 採択率計算用
for(i in -Nb:N) {
mean <- (n*Xbar/sig2+mu0/sig20)/(n/sig2+1/sig20) # 直前のsig2を用いる。
sd <- sqrt(1/(n/sig2+1/sig20))
a1 <- Xbar # 提案分布のパラメータ : 独立連鎖
b1 <- 0.5 # 提案分布のパラメータ(採択率の調整)
cand_mu <- rnorm(1,a1,b1)
alpha <- min(1, (dnorm(cand_mu, mean, sd)/dnorm(mu, mean, sd))*
(dnorm(mu,a1,b1)/dnorm(cand_mu,a1,b1)))
u <- runif(1)
if(u < alpha){
mu <- cand_mu
if(i > 0) N_mu <- N_mu+1 #採択数カウント
}
nu1 <- (n+nu0)/2
ramda1 <- (Sum2+n*(mu-Xbar)^2+ramda0)/2 # 直前のmuを用いる。
a2 <- 1 # 提案分布のパラメータ : 独立連鎖
b2 <- 0.1 # 提案分布のパラメータ(採択率の調整)
cand_var <- rnorm(1,a2,b2)
alpha <- min(1, (dinvgamma(cand_var,nu1,ramda1)/dinvgamma(var,nu1,ramda1))*
(dnorm(var,a2,b2)/dnorm(cand_var,a2,b2)))
u <- runif(1)
if(u < alpha){
var <- cand_var
if(i > 0) N_var <- N_var+1 # 採択数カウント
}
sig2 <- var # 初めに戻ってmeanの計算に用いる。
sig <- sqrt(var)
if(i > 0) {
sample_mu[i] <- mu #μのサンプル
sample_var[i] <- var #σ^2のサンプル
sample_sd[i] <- sig #σのサンプル
}
}
N_mu/N # 採択率
N_var/N # 採択率
summary(sample_mu)
summary(sample_var)
st_mu <- c(mean(sample_mu),sd(sample_mu))
st_var <- c(mean(sample_var),sd(sample_var))
print(st_mu)
print(st_var)
plot(sample_mu,type="l")
par(ask=TRUE)
plot(density(sample_mu))
par(ask=TRUE)
plot(sample_var,type="l")
par(ask=TRUE)
plot(density(sample_var))

7.結果の表示
> N_mu/N #採択率
[1] 0.25258
> N_var/N #採択率
[1] 0.89771
> summary(sample_mu)
Min. 1st Qu. Median Mean 3rd Qu. Max.
4.623 5.027 5.095 5.095 5.163 5.485
> summary(sample_var)
Min. 1st Qu. Median Mean 3rd Qu. Max.
0.5566 0.9185 1.0090 1.0220 1.1120 1.6640
> st_mu <- c(mean(sample_mu),sd(sample_mu))
> st_var <- c(mean(sample_var),sd(sample_var))
> print(st_mu)
[1] 5.0947409 0.1003362
> print(st_var)
[1] 1.0220987 0.1463964


2009年1月19日月曜日

Gibbsサンプラーを用いた正規母集団パラメータのベイズ推定

Xi (i = 1~n)を正規母集団N(μ、σ2)からのi.i.d.サンプルとする。Rを用いたGibbsサンプラーによるμとσ2のベイズ推定例を示す。
(参考文献)中妻照雄著「入門ベイズ統計学」、朝倉書店、p.145。

1.事前分布


2.尤度関数


3.事後分布


4.未知パラメータの全条件付事後分布


5.Gibbsサンプラーのアルゴリズム


6.Rコードの一例
library(MCMCpack) # rinvgamma()を使用するため
X <- c(0.0459, 0.0436, 0.0207, 0.0867, 0.1678, 0.1748) #データ
n <- NROW(X)
Xbar <- mean(X)
Sum2 <- sum((X-Xbar)^2)
mu0 <- 0.0 # ハイパーパラメータ
sig20 <- 0.01 # ハイパーパラメータ (sig20はτ02を表す。)
nu0 <- 36.0 # ハイパーパラメータ
ramda0 <- 1.36 # ハイパーパラメータ
N <- 100000 # サンプル数
Nb <- 1000 # burn-in
sample_mu <- 1:N
sample_sd <- 1:N
sample_var <- 1:N
sig2 <- 1.0 # 初期値
for(i in -Nb:N) {
mean <- (n*Xbar/sig2+mu0/sig20)/(n/sig2+1/sig20)
sd <- sqrt(1/(n/sig2+1/sig20))
mu <- rnorm(1,mean,sd)
alpha <- (n+nu0)/2
beta <- (Sum2+n*(mu-Xbar)^2+ramda0)/2
sig2 <- rinvgamma(1,alpha,beta)
if(i > 0) {
sample_mu[i] <- mu #μのサンプル
sample_var[i] <- sig2 #σ^2のサンプル
sample_sd[i] <- sqrt(sig2) #σのサンプル
}
}
summary(sample_mu)
summary(sample_sd)
st_mu <- c(mean(sample_mu),sqrt(var(sample_mu)))
st_sd <- c(mean(sample_sd),sqrt(var(sample_sd)))
print(st_mu)
print(st_sd)
plot(sample_mu,type="l")
par(ask=TRUE)
hist(sample_mu, breaks=seq(-0.5,0.5,0.05))
par(ask=TRUE)
plot(sample_var,type="l")
par(ask=TRUE)
hist(sample_var)

7.結果の表示
> summary(sample_mu)
Min. 1st Qu. Median Mean 3rd Qu. Max.
-0.25730 0.01666 0.05740 0.05707 0.09790 0.37190
> summary(sample_sd)
Min. 1st Qu. Median Mean 3rd Qu. Max.
0.1187 0.1719 0.1847 0.1867 0.1995 0.3342
> print(st_mu)
[1] 0.05707447 0.06054553
> print(st_sd)
[1] 0.18669853 0.02113967


2009年1月18日日曜日

Rにおけるgamma分布と逆gamma分布

逆gamma分布関数が使えないとき(ExcelやBUGSなど)、gamma分布関数を用いて逆gamma分布に従う乱数を生成する。ライブラリMCMCpackのrinvgamma()を利用して結果を確認する。

1.逆gamma分布のshapeパラメータとscaleパラメータの値を次のように仮定する。
shape = 10, scale = 5

2.それぞれの分布の乱数xとxxを10000ずつ生成する。
library(MCMCpack)
x <- rinvgamma(10000,shape=10,scale=5)
y <- rgamma(10000,shape=10,scale=1/5)
xx <- 1/y

3.各乱数の平均値と標準偏差を表示する。下は計算結果の一例。
mean(x)
[1] 0.5553811
sd(x)
[1] 0.1964493
mean(xx)
[1] 0.5556282
sd(xx)
[1] 0.1964432

4.密度分布やヒストグラムを描く。
hist(x,xlim=c(0,2),axes=F ,xlab="",ylab="",main="")
par(new=T)
plot(density(x),xlim=c(0,2))
par(ask=T)
hist(xx,xlim=c(0,2),axes=F ,xlab="",ylab="",main="")
par(new=T)
plot(density(xx),xlim=c(0,2))

2008年12月28日日曜日

OpenBUGS

OpenBUGS(for Windows)のインストールと使用方法

OpenBUGSはフリーソフトであり、Windows版やLinux版がある。OpenBUGSには、単体で使用する方法と、Rに組み込んで使用する方法がある。RからBUGS(OpenBUGSやWinBUGS14)を利用するには、パッケージR2WinBUGSあるいはBRugsなどをインストールしておく必要がある。

1.Rに組み込んで使用する方法
1)Rを起動し、「パッケージ」-「パッケージの読み込み」をクリックする。

2)R2WinBUGSを一覧から選択し、OKを押す。

3)インストールが完了すると、次のようにR2WinBUGSがRのライブラリーに追加される。(パッケージBRugsも同様にすればインストールできる。)

注)ライブラリR2WinBUGSを使用してRからBUGSを実行するには、別途下記のURLよりフリーソフトWinBUGS14(現在の最新版はWinBUGS1.4.3)をダウンロードして保存し、bugs関数においてbugs.directory="c:/Program Files/WinBUGS14/"のようにディレクトリを指定する。
http://www.mrc-bsu.cam.ac.uk/bugs/
あるいは、WinBUGS14を使用せず、OpenBUGSを使用する場合は次の2通りの方法がある。いずれもRのライブラリBRugsをインストールしておく必要がある。
1:bugs関数においてbugs.directoryを指定する代わりにprogram = "openbugs"を指定する。
2:bugs関数の代わりにopenbugs関数を用い、bugs.directory="c:/Program Files/OpenBUGS/と指定する。
このようにすれば、RはBRugsをロードし、OpenBUGSが実行される。OpenBUGSはBRugsに含まれているので、別途ダウンロードする必要はない。
なお、以上はライブラリR2WinBUGSを使用する場合であるが、ライブラリBRugsを使用したBUGSプログラミングも可能である。

2.単体で使用する方法
1)OpenBUGSのホームページ
http://www.mathstat.helsinki.fi/openBUGS/

http://www.openbugs.info/w/

からOpenBUGS(zipファイル)をダウンロードする。

(Windows用にはセットアップ用実行ファイルがダウンロードできる。)
2)ダウンロードしたzipファイルを適当なフォルダに解凍する。
3)フォルダ内の実行ファイルwinbugs.exeをクリックするとWinBUGSが起動する。
(以下、WinBUGSとあるのはすべてOpenBUGSに修正。)


4)例として、Examplesにある例題を実行する。WinBUGSのファイルは拡張子がodcのファイルである。「File」-「Open」をクリックし、Examplesのフォルダを開く。

5) その中のファイルSeeds.odcを開く。


6)画面をスクロールし、下方にあるmodelを表示する。

7)メニューの「Model」-「specification」をクリックする。
                                                                 
 
8)画面上のmodelの文字をマウスで選択してハイライトし、「Specification Tool」の「check model」をクリックする。modelに文法的な誤りがなければ次のような表示画面(左下のメッセージに注意)となる。

9)画面を更に下方へスクロールし、Data、Initsなどを表示させる。

10)Dataをクリックすると、データリストが表示される。listの文字部分をハイライトし、「Specification Tool」の「load data」をクリックする。正常にデータがロードされると下の画面が表示される。

11)modelとdataがロードされた後に、「compile」をクリックする。正常にコンパイルされると下の画面が表示される。

12)続いて初期値をロードする。Initsをクリックすると次の画面が表示される。

13)これまでと同様にlistの文字をハイライトし、「load inits」をクリックする。Chainの数が複数あるときは、chainの数だけ初期値設定をロードする。自動的に初期値を設定するには「gen inits」をクリックすればよい。

14)実行後の結果のグラフなどを参照する準備のため、メニューから「Inference」-「Samples」をクリックして「Sample Monitor Tool」を起動させる。

15)「node」に推定結果対象となる変数を入力する。この例ではalpha0, alpha2, alpha12, tau, sigmaなどである。変数名を入力するたびに「set」をクリックする。入力後はXを押して閉じる。

16)同様にメニューから「Inference」-「Summary」をクリックして「Summary Monitor Tool」を起動し、「node」に変数名を入力する。終了後は右上のXを押して画面を閉じる。

17)以上で準備が完了したので、BUGSを実行するため、Modelのアップロードを行う。メニューから「Model」-「Upload」をクリックする。
18)「Update Tool」が起動するので、サンプル数とburn-in、thinなどを入力する。入力後に「update」を押すとBUGSが実行される。

下は実行後の画面。計算時間も表示される。右上のXを押して画面を閉じる。

19)実行後の結果を見るため、メニューの「Inference」-「Samples」をクリックし、「Sample Monitor Tool」を起動させる。結果を知りたい変数をnodeから選ぶと、下部のボタンがONになるので、trace, history, densityなどをクリックすると結果がグラフ表示される。


20)また、メニューから「Inference」-「Summary」をクリックすると「Summary Monitor Tool」が起動するので、「node」から変数を選び「stat」をクリックするとその変数の統計量が表示される。


注)ODCファイルはmodelやdata等をひとまとめにしたファイルなので、保存や管理に便利であるが、以上の操作を行う場合、ODCファイルを作成していなくても同様の操作は可能である。modelファイルやdataファイル等をテキストファイルとして個々に作成し、それらを同じ作業ディレクトリに保存し、「File」から読み込んで同様の操作をすればよい。

* ODCファイルの作成
1) WinBUGSを起動し、「File」-「New」をクリックしてエディタを表示する。

2)model, data, 初期値をコピー&ペーストする。


3)適当なファイル名を付け、odcファイルとして保存する。

以上